"하거나 말거나" (All or Nothing)
소프트웨어를 개발하다 보면 수많은 기술 용어를 접하지만, 그중에서도 가장 비즈니스적인 무게감을 가진 단어는 단연 트랜잭션일 것입니다.
어원적으로 Trans(넘다)와 Action(행동하다)의 합성어인 이 단어는 서로의 경계를 넘어 어떤 일을 완결하다라는 뜻을 가집니다. 데이터베이스 관점에서는 시작이 있으면 반드시 끝이 있어야 하는 하나의 논리적 작업 단위가 되죠.
트랜잭션이 필요한 이유
트랜잭션의 대전제는 단순합니다. 여러 단계의 연산이 하나의 묶음으로 처리되어야 하며, 그중 하나라도 실패하면 모든 작업은 없었던 일이 되어야 합니다. 이를 데이터베이스의 ACID 원칙 중 원자성(Atomicity)이라고 합니다.
가장 대표적인 계좌 이체 시나리오를 예로 들어보겠습니다.
상황: A가 B에게 100만 원을 이체한다.
- A의 잔액에서 100만 원을 차감한다.
- B의 잔액에 100만 원을 추가한다.
이 두 과정은 반드시 운명 공동체여야 합니다. 1번은 성공했는데 2번에서 에러가 발생했다면? 시스템은 즉시 시간을 되돌려(Rollback) A의 잔액을 원상복구 시켜야 합니다. 돈이 증발하는 상황은 용납될 수 없으니까요.
- Commit: 모든 작업이 온전히 성공하여 결과를 확정하는 것.
- Rollback: 작업 중 실패가 발생하여 실행 이전 상태로 되돌가는 것.
Spring의 우아한 해결책, `@Transactional`
데이터베이스에 머물러 있던 트랜잭션의 개념을 코드 레벨로 끌어올린 것이 바로 스프링의 **@Transactional**입니다.
이 어노테이션의 역할은 단순히 DB와 통신하는 것을 넘어, 비즈니스 로직의 완결성을 보장하는 데 있습니다. 데이터베이스가 데이터의 무결성을 책임졌다면, 스프링은 그 위에서 돌아가는 우리의 코드가 안전하게 끝맺음할 수 있도록 돕습니다.
개념은 단순합니다. @Transactional이 선언된 메서드는 운명 공동체가 됩니다. 시작부터 끝까지 모든 코드가 예외 없이 실행되어야만 성공으로 인정받고, 단 한 줄이라도 삐끗하면 가차 없이 처음 상태로 되돌아갑니다. 즉, 개발자는 이 로직은 중간에 멈추는 애매한 상태가 존재하지 않음을 확신하고 코드를 작성할 수 있게 되는 셈입니다.
이제 이 강력한 도구가 내부적으로 어떻게 동작하는지 상세히 알아보겠습니다.
스프링이 트랜잭션을 다루는 방식: 투명한 프록시(Proxy)
순수하게 자바 코드로만 트랜잭션을 관리하려면, 비즈니스 로직 앞뒤로 트랜잭션의 시작과 끝을 명시하는 코드가 필요합니다. 이는 정작 중요한 비즈니스 로직보다 부가적인 관리 코드가 더 길어지는 주객전도 현상을 만들기 쉽습니다.
스프링은 이 문제를 AOP(Aspect Oriented Programming) 기술을 이용해 깔끔하게 해결했습니다. 개발자는 그저 메서드 위에 @Transactional이라는 이름표만 붙이면 됩니다.
프록시, 대신 처리해 주는 껍데기
어떻게 이게 가능할까요? 비밀은 프록시(Proxy)에 있습니다. 우리가 비즈니스 로직에 @Transactional을 붙이는 순간, 스프링은 해당 클래스를 감싸는 가상의 껍데기(Proxy) 객체를 생성합니다.
외부에서 요청이 들어오면, 실제 서비스 객체 대신 이 프록시가 먼저 요청을 가로채서 트랜잭션의 시작과 끝을 대신 관리해 줍니다.
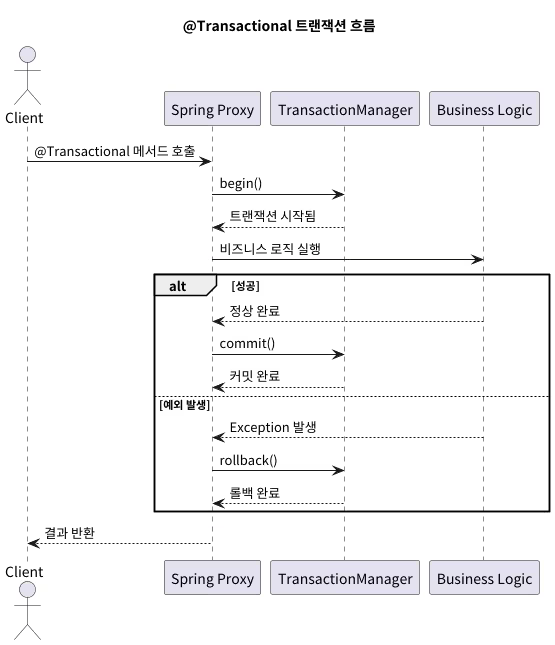
이 구조 덕분에 개발자는 트랜잭션을 어떻게 열고 닫을지 전혀 고민하지 않고, 오직 핵심 비즈니스 로직을 구현하는 데에만 집중할 수 있게 됩니다. 이것이 프레임워크가 주는 생산성의 핵심입니다.
`@Transactional`의 주요 속성들
단순히 @Transactional을 붙이는 것만으로도 트랜잭션은 동작합니다. 하지만 비즈니스 요구사항은 복잡하고, 우리는 때때로 더 섬세한 제어가 필요합니다.
아래는 @Transactional 어노테이션의 정의 코드입니다. 각 속성의 목적과 의미를 간단히 주석으로 덧붙였습니다.
@Target({ElementType.TYPE, ElementType.METHOD})
@Retention(RetentionPolicy.RUNTIME)
@Inherited
@Documented
@Reflective
public @interface Transactional {
// 사용할 트랜잭션 매니저 이름 (별칭 관계)
@AliasFor("transactionManager")
String value() default "";
// 사용할 트랜잭션 매니저 이름 (value와 동일)
@AliasFor("value")
String transactionManager() default "";
// 트랜잭션 라벨 (5.3+), 설명용 또는 모니터링용 태그
String[] label() default {};
// 트랜잭션 전파 방식 (Propagation behavior)
Propagation propagation() default Propagation.REQUIRED;
// 트랜잭션 격리 수준 (Isolation level)
Isolation isolation() default Isolation.DEFAULT;
// 트랜잭션 제한 시간 (초 단위)
int timeout() default TransactionDefinition.TIMEOUT_DEFAULT;
// 문자열로 설정하는 타임아웃 (예: ${tx.timeout})
String timeoutString() default "";
// 읽기 전용 트랜잭션 여부 (성능 최적화 힌트)
boolean readOnly() default false;
// 롤백을 수행할 예외 타입 지정
Class<? extends Throwable>[] rollbackFor() default {};
// 롤백을 수행할 예외 이름(패턴) 지정
String[] rollbackForClassName() default {};
// 롤백을 수행하지 않을 예외 타입 지정
Class<? extends Throwable>[] noRollbackFor() default {};
// 롤백을 수행하지 않을 예외 이름(패턴) 지정
String[] noRollbackForClassName() default {};
}
1) propagation - 트랜잭션 전파 방식
"이미 트랜잭션이 진행 중인데, 또 다른 트랜잭션 메서드를 호출하면 어떻게 될까요?" 전파 속성은 트랜잭션 간의 관계를 정의합니다. 마치 달리기 계주에서 바통을 이어받을지, 아니면 독자적인 코스를 달릴지 결정하는 것과 같습니다.
| Propagation | 설명 | 비고 |
|---|---|---|
| REQUIRED (Default) | 현재 트랜잭션이 있으면 합류하고, 없으면 새로 시작합니다. | 가장 일반적인 기본값 |
| REQUIRES_NEW | 항상 새로운 트랜잭션을 만듭니다. 기존 트랜잭션은 잠시 보류됩니다. | 독립적인 로깅, 감사(Audit) 기록 등에 사용 |
| NESTED | 부모 트랜잭션 안에 Savepoint를 만들어 부분 롤백을 지원합니다. | JDBC 지원 필요, 부모 실패 시 자식도 롤백 |
| SUPPORTS | 트랜잭션이 있으면 참여하고, 없으면 없이 실행합니다. | 단순 조회 로직 등에 사용 |
| NOT_SUPPORTED | 트랜잭션이 있으면 잠시 중단하고, 트랜잭션 없이 실행합니다. | 외부 API 호출 등 트랜잭션이 불필요한 구간 |
| MANDATORY | 반드시 트랜잭션 내에서 실행되어야 합니다. 없으면 예외가 발생합니다. | 호출자가 트랜잭션을 보장해야 할 때 |
| NEVER | 트랜잭션이 있으면 예외를 발생시킵니다. | 트랜잭션이 섞이면 안 되는 작업에 사용 |
위의 표를 보았을 때 NEVER있는 것으로도 알 수 있듯, @Transactional은 트랜잭션을 사용하지 않기 위해서도 사용할 수 있습니다.
2) Isolation: 트랜잭션 격리 수준
동시에 여러 트랜잭션이 실행될 때, 남의 트랜잭션이 하는 일을 어디까지 모른 척할 것인가를 결정합니다. 격리 수준이 높을수록 데이터의 정확성(일관성)은 높아지지만, 동시 처리 성능은 떨어집니다. 이 Trade-off를 이해하는 것이 핵심입니다.
발생할 수 있는 이상 현상 (Side Effects)
- Dirty Read: 커밋되지 않은(임시) 데이터를 다른 트랜잭션이 읽는 현상
- Non-Repeatable Read: 같은 쿼리를 두 번 실행했는데, 그사이 다른 트랜잭션이 수정해 결과가 달라지는 현상
- Phantom Read: 같은 조건으로 조회했는데, 다른 트랜잭션이 추가/삭제해 결과 건수가 달라지는 현상
격리 수준 비교
| Isolation Level | Dirty Read | Non-Repeatable | Phantom Read | 설명 |
|---|---|---|---|---|
| DEFAULT | - | - | - | 사용하는 DB의 기본 설정을 따름 |
| READ_UNCOMMITTED | O | O | O | 커밋 안 된 데이터도 읽음. 가장 빠르지만 위험함 |
| READ_COMMITTED | X | O | O | 커밋된 데이터만 읽음 (Oracle, PostgreSQL 기본) |
| REPEATABLE_READ | X | X | O | 트랜잭션 내에서 조회 결과의 일관성 보장 (MySQL 기본) |
| SERIALIZABLE | X | X | X | 완벽한 순차 실행. 데이터는 안전하나 성능 저하가 큼 |
3) readOnly - 읽기 전용 트랜잭션
단순히 데이터를 조회만 하는 메서드라면, @Transactional(readOnly = true) 설정은 선택이 아니라 필수에 가깝습니다. 이 옵션 한 줄이 애플리케이션과 데이터베이스 양쪽 모두에게 엄청난 성능 이점을 가져다주기 때문입니다.
① 동작 원리: 내부에서 무슨 일이 일어날까?
이 옵션을 켜면 스프링은 내부적으로 다음과 같은 최적화를 수행합니다.
- JPA / Hibernate 레벨 (메모리 & CPU 절약):
- 스냅샷 생성 생략: JPA는 변경 감지(Dirty Checking)를 위해 엔티티 조회 시점의 상태를 복사해 둡니다(스냅샷). 하지만 읽기 전용이라면 변경할 일이 없으므로 이 스냅샷을 만들지 않습니다. 덕분에 메모리 사용량이 줄어듭니다.
- 플러시(Flush) 생략: 트랜잭션이 끝날 때 변경 내용을 DB에 동기화하는 '플러시' 과정을 수행하지 않습니다. 불필요한 연산을 줄여 CPU 자원을 아낍니다.
- JDBC / DB 레벨 (리소스 효율화):
Connection.setReadOnly(true)를 호출하여 DB 드라이버와 데이터베이스에 "이 트랜잭션은 읽기만 할 거야"라는 힌트를 줍니다. DB는 이에 맞춰 내부 락(Lock) 전략을 완화하거나 불필요한 리소스 할당을 줄여 쿼리 성능을 높입니다.
② 주의: 프레임워크마다 다릅니다
readOnly는 만능키가 아닙니다. 사용하는 기술 스택에 따라 동작 방식이 다릅니다.
- JPA: 위에서 언급한 대로 변경 감지나 플러시를 막아주어 확실한 성능 향상을 보장합니다.
- MyBatis: 이야기가 다릅니다. MyBatis는 JPA처럼 변경 감지를 관리해 주는 프레임워크가 아닙니다. 여기서의
readOnly는 단지 DB 드라이버에 보내는 힌트일 뿐입니다. 드라이버나 DB 설정에 따라 성능 최적화가 될 수도, 무시될 수도 있음을 인지해야 합니다.
⚠️ 경고: 에러 없이 데이터가 증발할 수 있습니다.
readOnly = true로 설정된 트랜잭션 안에서 save()나 update 로직을 실수로 실행하면 어떻게 될까요?
놀랍게도 예외(Exception)가 발생하지 않을 수 있습니다. 코드는 정상적으로 돌아가는 것처럼 보이지만, 실제 데이터베이스에는 반영되지 않습니다(JPA의 경우 플러시가 안 되므로 쿼리 자체가 안 나갑니다).
"에러가 안 나니까 저장됐겠지?"라고 착각하기 쉬운 포인트이므로, 데이터 변경이 필요한 곳에는 절대 사용하면 안 됩니다.
4) rollback - 롤백 통제
트랜잭션을 사용하는 목적은 "성공하면 다 같이 저장(Commit), 실패하면 다 같이 취소(Rollback)"하기 위함입니다. 그렇다면 스프링은 실패'의 기준을 무엇으로 볼까요?
놀랍게도 모든 예외(Exception)가 롤백을 유발하지는 않는다는 점을 반드시 기억해야 합니다.
① 스프링의 기본 원칙: "예측 가능했는가?"
스프링은 예외의 성격에 따라 롤백 여부를 다르게 판단합니다.
- Unchecked Exception (런타임 예외): 자동 롤백
NullPointerException,IllegalArgumentException등- 의미: "이건 개발자의 실수거나 시스템 장애다." 복구가 불가능한 치명적인 오류로 간주하여 즉시 롤백합니다.
- Checked Exception (체크 예외): 커밋 (롤백 안 함)
IOException,SQLException, 그리고 직접 만든 비즈니스 예외 등- 의미: "이건 비즈니스 로직상 발생할 수 있는 '예외적인 상황'이다." 개발자가
try-catch로 복구할 기회를 주기 위해, 기본적으로는 롤백하지 않고 커밋합니다.
Throwable
├─ Error ← Unchecked (시스템 오류: 롤백 O)
└─ Exception
├ RuntimeException ← Unchecked (개발자 실수: 롤백 O)
└ (그 외 Exception) ← Checked (예외적 상황: 롤백 X -> 커밋됨!)② 실무에서의 딜레마와 해결책
문제는 실무에서 사용하는 많은 비즈니스 예외(Business Exception)들이 Checked Exception으로 만들어질 때 발생합니다.
예를 들어, 결제 시스템에서 NotEnoughBalanceException(잔액 부족)이 발생했다고 가정해 봅시다. 이는 비즈니스 로직상이지만, 데이터 정합성을 위해 반드시 롤백되어야 하는 상황일 수 있습니다. 하지만 스프링의 기본 정책상 이 예외는 커밋되어 버립니다.
이럴 때 우리는 스프링에게 이 예외도 롤백해줘라고 명시적으로 알려줘야 합니다.
// "Exception 클래스 하위의 모든 예외(체크 예외 포함) 발생 시 롤백해라"
@Transactional(rollbackFor = Exception.class)
public void pay(PaymentRequest request) throws Exception {
// ...
}rollbackFor: 기본적으로 커밋되는 체크 예외를 롤백 대상에 포함시킬 때 사용합니다. (실무에서 가장 많이 사용)noRollbackFor: 반대로, 런타임 예외지만 롤백하지 않고 커밋하고 싶을 때 사용합니다. (예: 로그 저장 실패 등 사소한 오류)
마무리
지금까지 @Transactional의 기본 원리와 핵심 속성들을 살펴보았습니다.
이 어노테이션 덕분에 우리는 지루한 반복 코드 없이도 데이터의 일관성과 비즈니스의 신뢰성을 강력하게 지킬 수 있게 되었습니다. 잘 쓰면 더할 나위 없이 든든한 무기죠.
하지만 무기가 강력할수록 다루기는 까다로운 법입니다. 실무에서는 트랜잭션이 의도대로 동작하지 않거나, 예상치 못한 이유로 무시되는 상황을 종종 마주하게 됩니다.
다음 글에서는 이 도구를 완벽하게 제어하기 위해, 스프링 트랜잭션의 작동 흐름에 대해 깊이 있게 파헤쳐 보겠습니다.